Strategyパターンで安全に外部メールサービスの移行を進める方法
一時テーブルを利用してバッチ処理を改善
1. 概要
履歴ファイル作成バッチのリファクタリング(ほぼリメイク)を行い、一時テーブルを利用して検索を複数ステップに分けることで可読性やテスタビリティを向上させて、さらに処理時間を5時間以上から40分にまで短縮させることができましたので、その方法について説明します。
2. 背景
私は決済に関するプロダクトの開発に携わっており、そのプロダクトには決済に関する取引履歴を検索してファイルとして出力する「取引履歴ファイル作成バッチ」が存在していました。
このバッチの機能としては管理者用のアプリケーションの取引履歴検索画面から検索条件を指定して、ファイル作成ボタンを押すことで、バッチが起動されCSVファイルが作成されるというものになります。
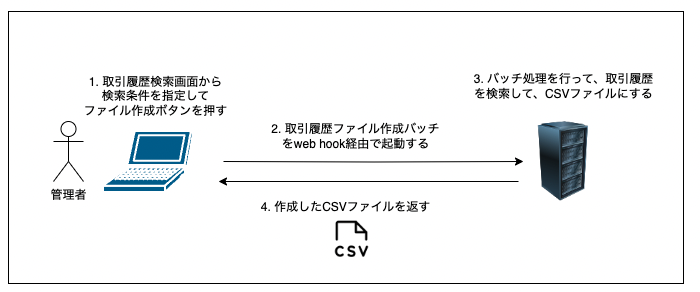
またバッチ内部では、以下の処理フローでファイルが作成されていました。
改善前のバッチの処理フロー
3. 課題
しかしながらこのバッチには以下の3つの課題が存在していました。
- 可読性が低い
- テスタビリティが低い
- 性能が低い
3.1. 課題1. 可読性が低い
1つ目の課題は「可読性が低い」ことです。
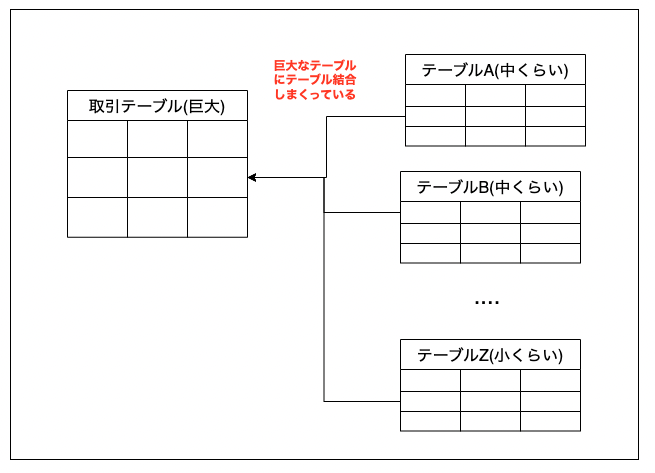
具体的には、このバッチの[検索処理]の際に実行されているクエリは取引履歴テーブルだけでなく他にも様々なテーブルを結合しており、クエリが非常に巨大でコードを読むのが辛いものでした。
select
  transaction.hoge,
  transaction.fuga,
  table_a.hogehoge,
  ... 他にも沢山
  table_z.huge

from transaction as t

join table_a as a on t.id = a.transaction_id
join table_b as b on a.id = b.a_id
... 他にもテーブル結合が沢山
join table_z as z on y.id = z.y_id

where t.transaction_date between '2022-01-01' and '2022-02-01';
3.2. 課題2. テスタビリティが低い
2つ目の課題は「テスタビリティが低い」ことです。
1つ目の課題にあるようにこのバッチの検索クエリはかなり複雑なもので、お世辞にもテストコードが書きやすいものではありませんでした。
実際、このバッチにはテストコードがなく、手動テストのみでした。
3.3. 課題3. 性能が低い
3つ目の課題は「性能が低いこと」です。
具体的にはこのクエリはレコード数が多い巨大な取引履歴テーブルに対して何度もアクセスを行っては、テーブル結合をしており、クエリ全体としての処理時間がとても長いものでした。
例えば1000万件が検索対象となる条件の場合だと、バッチ終了に5時間以上かかり、場合によっては推定で50時間もかかるという状況でした。
4. 一時テーブルを利用したバッチ処理のリメイク
そこで以上の3つの課題を解決するために、「2つの一時テーブルを利用して段階的に検索処理を行う」ように実装をリメイクしました。
処理フロー
- [検索処理1] idだけ検索し、id_tmpテーブルにselect&insertで挿入
- [検索処理2] idから5000件ずつselectして、テーブル結合して、select&insertしてcsv_tmpテーブルに挿入
- [ファイル作成処理] csv_tmpテーブルから5000件ずつselectしてcsvファイルへ書き込み
4.1. 検索処理1「取引idだけ検索」
まず検索処理1では取引テーブルから取引idだけを検索し、id_tmpテーブルという一時テーブルにselect&insertします。 このように、クエリを小さくシンプルすることで実装が読みやすくなり、同時にテストも書きやすくなります。
insert into id_tmp

select
  t.hoge,
  t.fuga,
  ...
  t.huga
from transaction as t

where transaction_date between '2022-01-01' and '2022-02-01'
4.2. 検索処理2「取引idを元に付帯情報を検索」
検索処理2では、まずid_tmpテーブルから取引idを少しずつselectして、それらの取引idから取引テーブルへレコードを取得するサブクエリを構築します。
つぎにそのサブクエリに他のテーブルを結合して、csv_tmpテーブルという一時テーブルにselect&insertをします。
ここで[検索処理1]で取得した取引idをもとに取引テーブルへのサブクエリを作成しておくことで、取引テーブルとの結合レコード数を減らして性能劣化を防ぐことができます。
-- 一時テーブルへinsert
insert into csv_tmp

-- insertする内容をselect
select
  t.hoge,
  a.huga,
  b.huga,
  ...
  z.huge,

-- 取引履歴のサブクエリテーブルを作成
from (
  select *
  from transaction
  where id in (
     1, 2, 5, 10, ... , 100
  )
) as t

-- 小さくなったサブクエリテーブルにテーブル結合
join t.id = a.transaction_id
join table_b as b on a.id = b.a_id
... 他にもテーブル結合が沢山
join table_z as z on y.id = z.y_id;
4.3. ファイル作成処理
最後にファイル作成処理ではcsv_tmpテーブルからレコードを少しずつselectしてはcsvに書き込みを繰り返してcsvファイルを作成します。
5. 改善の結果
このように改善したことで以下の3つのメリットが得られるようになりました。
5.1. 可読性が向上
まずは検索時のクエリが小さくなったことで可読性が向上したことが挙げられます。
元々は取引テーブルに別のテーブルを沢山結合していたのですが、クエリを段階的に実行する形式に変えることで1つ1つのクエリは小さくシンプルになり、可読性が向上しました。
5.2. テスタビリティが向上
次に挙げられる成果はテスタビリティが向上したことです。
1つ1つのクエリが小さくシンプルになったことで、それぞれのシンプルなクエリに対してテストを書けば良くなったので、結果としてテストが書きやすいようになりました。
それぞれのクエリごとにテストを書けるようになったことで、全体としてのテストケース数を抑えつつ網羅性を上げることもできるようになりました。
5.3. 処理性能が向上
最後に「処理性能が向上したこと」が挙げられます。
元々のクエリでは巨大なテーブルに対してjoinを行っていたためテーブル結合のコストが高くクエリの性能が劣化していました。
そのため、改善後のクエリではjoinではなく事前に検索した取引idを用いて取引テーブルから少しだけレコードを取得し、その結果のサブクエリテーブルに対して他のテーブルをjoinするようにすることで、テーブルの結合行数を減らして性能を上げることができました。
具体的には、処理時間が5時間以上から40分程度に短縮されました。
6. まとめ
今回は可読性・テスタビリティ・性能に課題があったバッチを一時テーブルを用いることで処理を改善する方法について説明しました。
なお、この方法のデメリットとしては管理するテーブル数が増加することがありますので、使い所は注意すべきかなと思います。
また今回はDBがRDB縛りだったりしたので、根本的に性能を上げたいような場合は別のアプローチを取ることをおすすめします。
以上
国内外のフィンテック企業のテックブログまとめ
はじめに
本記事は20230805時点で存在するフィンテック企業のテックブログについてまとめたリンク集です。 国内企業と国外企業に分けて章立てしていますが、ほとんど国内企業ばかりになってますね、、、もっといろんな企業を調べられるようにしたいです。
また以下のフォーマットで記入しています。 ex) - 企業名(事業ジャンル): URL
国内企業
- JCB(決済): https://tech.jcblab.jp/
- Layerx(バックオフィス全般): https://tech.layerx.co.jp/
- Marcari(merpay, 決済): https://engineering.mercari.com/blog/tag/merpay/
- Moneyforward Kessai(決済): https://tech.mfkessai.co.jp/
- Moneyforward 福岡開発拠点(決済): https://fukuoka.moneyforward.com/
- Moneyforward 関西開発拠点(会計): https://kyoto.moneyforward.com/blog/
- Moneyforward(PFM, 会計, fintech全般): https://moneyforward-dev.jp/
- Infcurion(決済): https://techblog.infcurion.com/
- PayPay株式会社(決済): https://blog.paypay.ne.jp/category/engineering/
- STORES(決済): https://product.st.inc/
- freeee(会計, バックオフィス業務): https://developers.freee.co.jp/
国外企業
- PayPal(決済): https://medium.com/paypal-tech
- Marqeta(決済), https://community.marqeta.com/t5/developer-blogs/bg-p/blogs
- mastercard(決済): https://developer.mastercard.com/blog/
以上
コード例で深ぼるEffectiveJava~「第2章コンストラクタの代わりにstaticファクトリメソッドの使用を検討する」の深掘り~
本記事では名著Effective Java(第3版)で言及されているtipsをより深掘りするために、さまざまなコード例を交えて考えるというものになります。
今回は第2章 オブジェクトの生成と消滅の中の項目1「コンストラクタの代わりにstaticファクトリメソッドを検討する」について深掘りします。
目次
- Staticファクトリメソッドとは?
- Staticファクトリメソッドのメリット
- Staticファクトリメソッドのデメリット
- おわりに
1. Staticファクトリメソッドとは
Staticファクトリメソッドとは、「クラスのインスタンスを返す単なるstaticのメソッド」であり、クラスのコンストラクタの代替手段になります。
実装時のポイントは「publicにしたstaticファクトリメソッドから、privateのコンストラクタを呼び出すことでインスタンス生成をする」ということです。
Effective Java内ではBooleanのvalueOf()メソッドが例として挙げられていましたが、よりweb開発者に向けた例としてUserクラスでStaticファクトリメソッドの説明をします。
public class User {
    private int id;
    private String name;

    // プライベートコンストラクタ
    private User(int id, String name) {
        this.id = id;
        this.name = name;
    }

    // staticファクトリメソッド
    public static User createUser(int id, String name) {
        return new User(id, name);
    }

    public static void main(String[] args) {
        User user = User.createUser(1, "Alice");
        System.out.println(user); // 出力: User{id=1, name='Alice'}
    }
}
まずこのUserクラスはidとnameをフィールドに持っており、コンストラクタのメソッドの可視性はprivateになっています。
これに対しstaticファクトリメソッドはpublicになっており、ファクトリメソッド内からprivateのコンストラクタを呼び出してインスタンス生成をしています。
サイトの移転
このブログは以下のサイトに移転されました
コード例で深ぼるEffectiveJava~「第2章コンストラクタの代わりにstaticファクトリメソッドの使用を検討する」の深掘り~ | yukio's techblog
オフライン電子決済の事例
はじめに
みなさん、「キャッシュレス決済したこと」はありますか? おそらく、多くの人が「1回はある」と答えると思います。
一方で、「オフラインでキャッシュレス決済したこと」がある人はどれほどいるでしょうか? おそらく、Yesと答える人はさほどいないのではないでしょうか?
本記事では、オフライン電子決済の事例の紹介を通して、オフライン電子決済の技術的な背景を知るきっかけ作りをしたいと思います。
目次
- ユーザのみオフラインでよいPayPay
- ユーザも店舗もオフラインで決済が可能なMondex
- ガラケーでのオフライン決済「DigiTally」
- 実はオフライン決済にも対応しているらしいデジタル中華人民元
- おわりに
サイトの移転
このブログは以下のサイトに移転されました。
正規表現のコンパイルをメモ化すると若干速くなるらしいのでローカル環境で検証してみた
「Effective Java 第3版」の第2章の項目6に「不必要なオブジェクトの生成を避ける」という内容のものがあり、そこで正規表現のコンパイルはクラス変数にキャッシングした方がパフォーマンスを大幅に改善できるとのことが書いてあったので、実際に試して確認してみました。
サイトの移転
このブログは以下のサイトに移転されました。
正規表現のコンパイルをメモ化すると若干速くなるらしいのでローカル環境で検証してみた | yukio's techblog
JOOQのbulk update, batch update, for文でのupdateはどれくらいの速度差があるのか?
目次
- はじめに
- jOOQとは
- 1万件のレコードをjOOQでアップデートする際の性能
- おわりに
1. はじめに
みなさんDBのデータ更新をする際になんとなくupdateしてませんか?
実は数万件単位のupdateをする際に、愚直にupdateするのとbulk updateするのとでは場合によっては100倍もの速度差がでることがあります。
本記事は, なんとなく機能要件を満たす開発スキルが身に付いてきた駆け出しのソフトウェアエンジニアに向けて効率的なupdateの方法とその仕組みについてご紹介したいと思います。
記事の移転
本記事は以下のサイトに移転しました
